Przygoda w startupie
Data publikacji: 2026-11-12
Wstęp
Na przełomie września i października 2024 roku odszedłem z Point72 i rozpocząłem pracę w startupie ConnectyAI jako founding engineer. Po dwóch latach moja przygoda startupowa dobiegła końca. W tym poście chciałbym podsumować moje odczucia i przemyślenia odnośnie do mojej pracy w tym okresie.
Dlaczego startup?
Po latach pracy w dużych organizacjach (PwC, Allegro Pay, Point72), często doświadczając:
- braku bezpośredniego wpływu na produkt końcowy oraz użytkowników
- relatywnie wolnego tempa wdrażania zmian
- relatywnie dużej ilości procesów, procedur oraz ogólnej biurokracji
Z drugiej strony oczywiście byłem świadomy zazwyczaj większego tempa pracy, większej odpowiedzialności oraz mniejszego bezpieczeństwa finansowego. Mimo wszystko postanowiłem, że jeśli taka sytuacja się nadarzy, to spróbuję swoich sił w startupie. Sam oczywiście miałem dużo pomysłów na swój własny startup, ale typowo prawie wszystkie moje pomysły tyczyły się produktów technicznych, dla programistów lub inżynierów danych. Wiedziałem, że nawet przy optymistycznych szacunkach bardzo ciężko zmonetyzować takie produkty (a to było jeszcze przed nadchodzącym rozwojem AI).
ConnectyAI
Wstępne rozmowy z CEO nowozałożonego startupu ConnectyAI odbyłem w sierpniu 2024 roku. Od samego początku bardzo mi się spodobało jego podejście oraz wizja produktu. Było to bardzo blisko tego, nad czym sam chciałbym pracować. Na tym etapie ConnectyAI budowało techniczną część zespołu i szukało founding engineerów. Po kilku rozmowach wstępnie zgodziłem się dołączyć, kiedy ConnectyAI sfinalizuje pierwszą rundę finansowania. Nastąpiło to dużo szybciej, niż myśleliśmy, i od września 2024 roku dołączyłem w pełnym wymiarze godzin do zespołu.
Celem ConnectyAI było stworzenie platformy, która umożliwi osobom nietechnicznym (product manager, marketing itd.) bezpośredni wgląd w dane, analizy oraz wyniki bez konieczności znajomości technologii oraz zlecania zadań/pytań analitykom danych lub inżynierom. Natomiast dla osób technicznych platforma ułatwiłaby dużą część zadań związanych z pracą nad danymi. W skrócie miało być to trochę jak ChatGPT dla danych. W naszym przypadku również głównym interfejsem użytkownika był chat zanurzony w aplikacji webowej. Bardzo podobała mi się ta wizja.
Początki
Moimi głównymi obszarami odpowiedzialności w początkowej fazie były infrastruktura (AWS) oraz ogólnie rozumiany backend (Go). Zaczynaliśmy od zera, więc początkowo było sporo pracy przy zaprojektowaniu i wdrożeniu architektury, skonfigurowaniu środowisk, procesów CI/CD, lokalnego środowiska oraz zaimplementowaniu szkieletu backendu, który wspierałby operacyjne działanie aplikacji webowej. Do tego kwestie wokół obsłużenia autentykacji użytkowników. Seria zadań niezbędnych, zanim w ogóle mogliśmy przejść do implementowania kluczowych funkcjonalności. Patrząc z perspektywy czasu, to jak na realia startupowe, spędziliśmy trochę za dużo czasu na tym etapie, ale do tego tematu jeszcze wrócimy później.
Chat
Jedną z pierwszych funkcjonalności, które musiałem zbudować po stronie backendu (poza wyżej wspomnianymi), był chat. Go pasował idealnie do tego zadania! Kombinacja gorutyn, kanałów oraz websocketów (gorilla/websocket) pozwoliła mi w relatywnie krótkim czasie zbudować stabilny i skalowalny chat. Była to jedna z rzeczy, których nigdy wcześniej nie implementowałem w produkcyjnych środowiskach (tylko w ramach prostych testów podczas nauki). Było to bardzo ciekawe i satysfakcjonujące doświadczenie.
RAG-i oraz agenci
Początkowym podejściem, jak wdrożyć LLM-y do rozwiązania naszego problemu, było przygotowanie jak najlepszego kontekstu dla zestawu wyspecjalizowanych agentów. W owym czasie było to naturalne i często stosowane podejście. Odbywało się to jeszcze, zanim pojawił się Claude Code oraz podejście agentowe rozwinęło się znacząco.
Selekcja kontekstu była kombinacją przeszukiwania odpowiednio przygotowanych wektorów (pgvector w
PostgreSQL) oraz naszego wewnętrznego wzbogaconego kontekstu modelu danych. W dzisiejszych czasach moglibyśmy
powiedzieć, że wtedy pracowaliśmy nad specjalistycznym harnessem dla LLM-ów w kontekście baz danych.
Źródła danych
Innym dużym i ważnym obszarem, który pokrywał backend, było zaprojektowanie oraz zaimplementowanie wsparcia dla różnych źródeł danych. W początkowej fazie były to głównie bazy danych SQL (PostgreSQL, Snowflake, Databricks itd.). Wyzwanie po stronie zaprojektowania wewnętrznego API było klasycznym problemem z tej kategorii. Chcemy mieć API, które będzie mogło zostać zaimplementowane przez jak największą liczbę źródeł danych, a z drugiej strony powinno być dostatecznie jawne i użyteczne dla wewnętrznych serwisów. Koniec końców z perspektywy czasu uważam, że udało się to całkiem nieźle.
Sama implementacja była już dosyć prosta, szczególnie przy pomocy LLM-ów (gdy mieliśmy już 1–2 wsparcia zaimplementowane solidnie, LLM-y dosyć dobrze radziły sobie z dodawaniem nowych). Po stronie wykonawczej więcej pracy było przy pokryciu konfiguracji połączenia oraz wsparciu możliwych ścieżek autentykacji. To musiało zostać udokumentowane oraz zaimplementowane po stronie Frontendu. Nadal nic trudnego, ale dodanie wsparcia dla nowego źródła danych wymagało nieco pracy i sporo testów.
<X> dla danych
Pierwsze kilka miesięcy pracy w ConnectyAI bardzo namacalnie pokazało nam, że przestrzeń problemów w rozwiązaniach dotyczących „danych” jest nieporównywalnie większa niż w przypadku rozwiązań dla „kodu”. Oczywiście byłem tego świadomy już od dawna, ale dopiero wtedy, pracując intensywnie nad tego typu produktem, poczułem to dosadnie.
Jednym przykładem z wyżej wspomnianej grupy jest „git dla danych”. Idea jest piękna i prosta. Chcemy móc wersjonować dane, analogicznie jak to robimy z kodem źródłowym. Łatwiej powiedzieć niż zrobić. Oczywiście powstało wiele rozwiązań tego typu, lecz żadne z nich nie zdobyło nawet ułamka popularności, jaką zdobył Git. Oczywiście nie jest to wina samych rozwiązań, ale po prostu problem jest dużo trudniejszy. Różne formaty danych, „miejsca”, gdzie dane są trzymane, sama skala rozmiaru danych itd. To wszystko sprawia, że problem jest dużo trudniejszy niż w przypadku kodu źródłowego.
W ConnectyAI wyzwań wynikających z większej przestrzeni problemów w obszarze danych było wiele. Dla przykładu wspomnę o jednym z nich. Powierzchownie proste zadanie: chcemy mieć próbkę wierszy danych dla danej kolumny z danego obiektu w bazie danych. Przykładowo
{
  "schema.table1.col1": [42, -5, 0, NULL, 1]
}TEXT lub JSONB, to przykładowo w
PostgreSQL pojedyncze wartości mogą ważyć aż do 1 GB. Raczej nie jest to częsty przypadek, ale zarówno backend
(przechowywanie i przesyłanie), jak i frontend (ogólny UX i renderowanie) muszą być na to przygotowane (lub omijać takie
wartości i obsługiwać to w inny sposób). Innym wyzwaniem jest to, jak efektywnie pobrać próbkę z dużej tabeli. To już
zależy od konkretnego silnika bazy danych. Większość z nich wspiera losowanie danej liczby wierszy, ale nie wszystkie.
Kolejnym problemem jest fakt, że dany obiekt schema.table1, wbrew nazwie, może nawet nie być tabelą w
bazie danych, a widokiem lub innym obiektem. W przypadku widoku może to być skomplikowane zapytanie, które operuje na
potencjalnie dużych tabelach lub innych widokach, które używają dużych tabel. Takie zapytanie może być bardzo
kosztowne, zarówno monetarnie, jak i czasowo. Byłoby to dosyć nieodpowiedzialne, gdyby ConnectyAI (3rd party
tool) wykonywał zapytania za >$100, aby wyciągnąć kilka wartości dla swoich wewnętrznych metadanych. Niektóre
silniki baz danych wspierają estymację kosztu danego zapytania lub przynajmniej estymację liczby bajtów
potrzebnych do przeczytania (na przykład BigQuery i Snowflake). W przypadku braku takich możliwości musimy
zaprojektować heurystyczną analizę na podstawie innych dostępnych metadanych, aby zminimalizować szansę na takie
sytuacje.
Aktualnie (2026, dwa lata później) widzimy podobne rozwiązania w przypadku dużych dostawców Google (BigQuery), Databricks oraz Snowflake. Każdy z wymienionych oferuje „asystenta” do pracy z danymi. W porównaniu z zakresem, który zaimplementowaliśmy w ConnectyAI, rozwiązania te są bardzo ograniczone. Co tylko wzmacnia punkt o złożoności rozwiązania problemów z tej przestrzeni.
Dynamika pracy
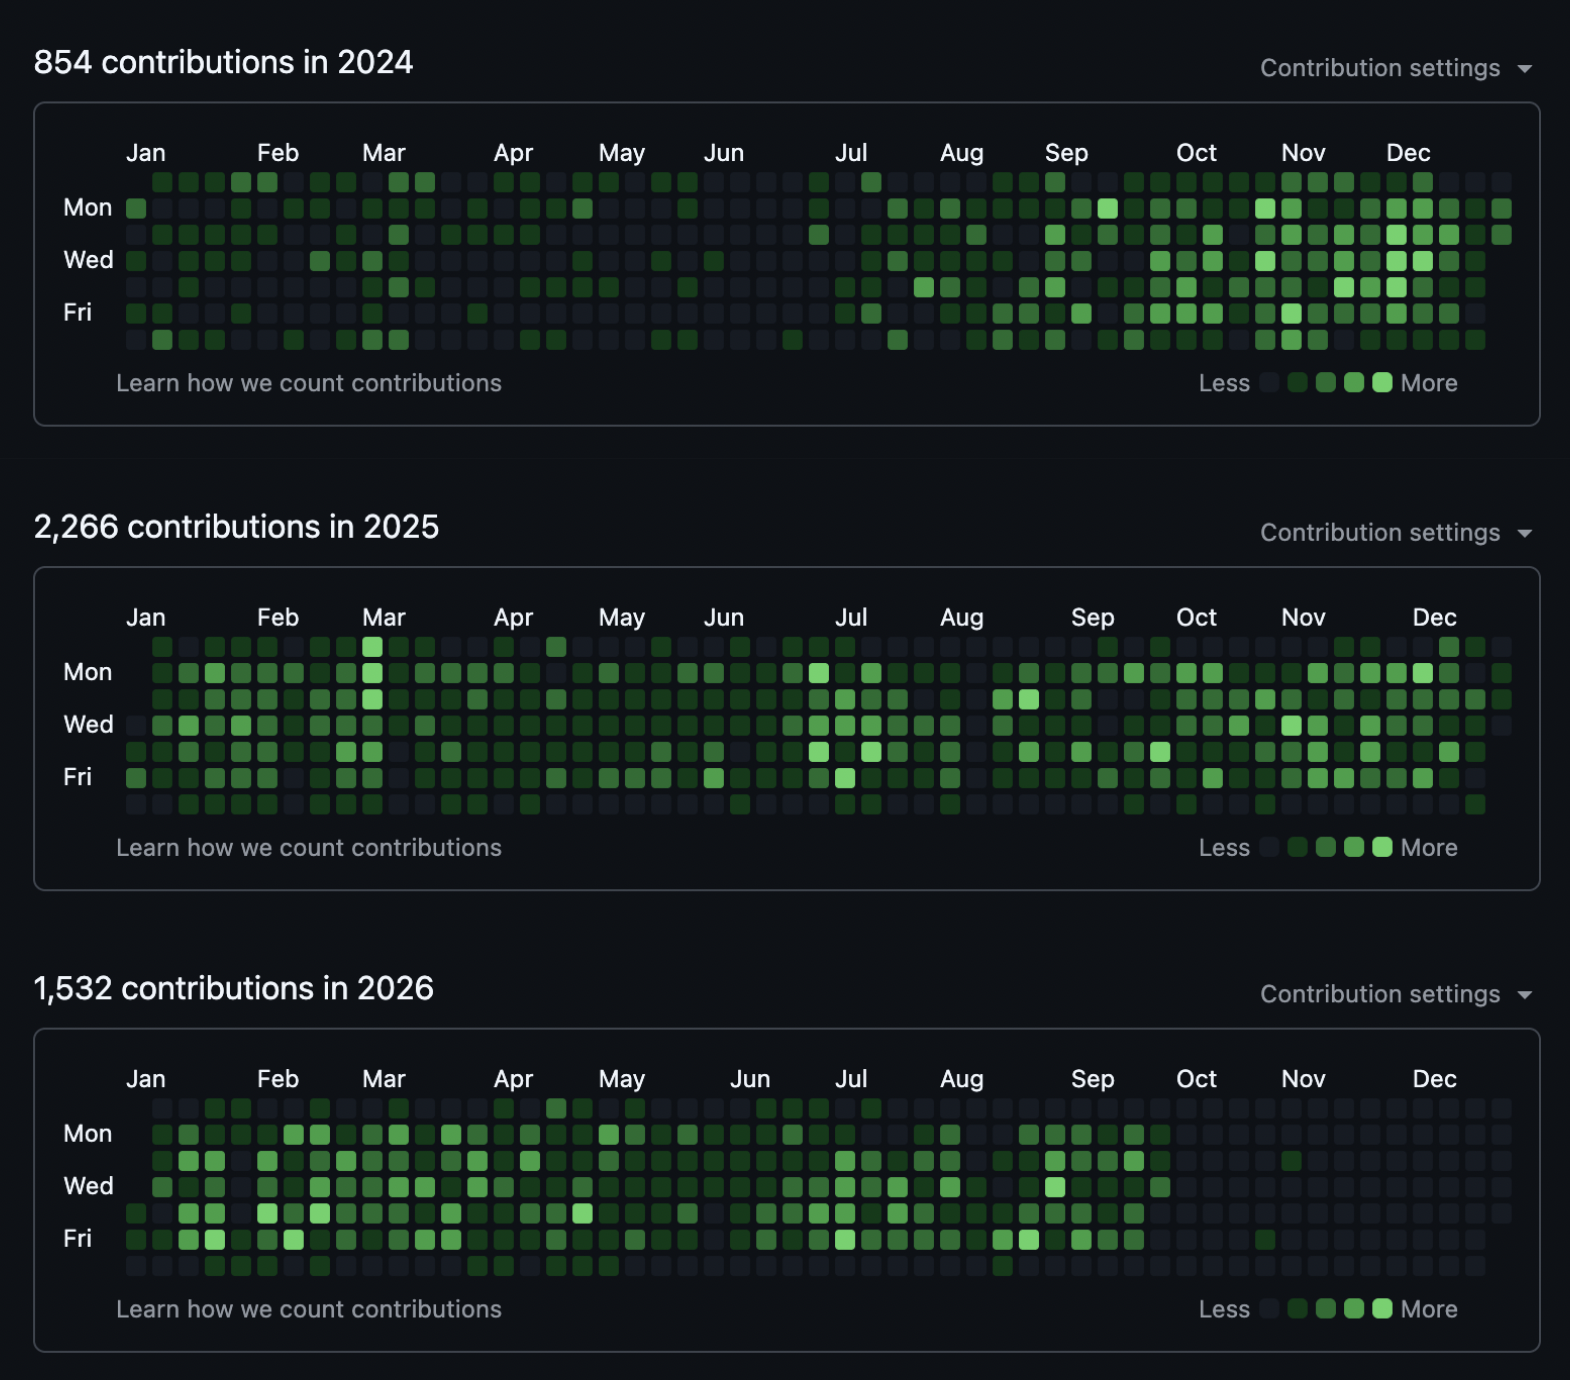
Aktywność na GitHubie
Zanim jeszcze dołączyłem do ConnectyAI, wiedziałem, że na ogół intensywność pracy w startupach jest duża. Potencjalnie większa niż we wszystkich miejscach, w których pracowałem do tej pory, łącznie z consultingiem (PwC). Nie była to tylko moja osobista kwestia. Intensywność i długość pracy potencjalnie mogły rzutować na moją rodzinę, w szczególności na moją żonę. Na szczęście moja żona jest bardzo wspierająca i potencjalna nowa sytuacja była dla niej do zaakceptowania. Także moje pełne zaangażowanie na co najmniej dwa lata w startupie było świadomą inwestycją.
Było tak, jak przypuszczałem. Pracy było dużo, a tempo wysokie. Nie było to doskwierające, ponieważ pracowaliśmy nad rozwojem naszej wizji i wdrożeniem jej w życie. Dynamika pracy była również odbiciem dynamiki współpracy z design partnerami oraz wstępnymi klientami. Wcześniej brakujący element wpływu na produkt oraz użytkowników był teraz w pełni obecny i materialny.
Pomimo dużej intensywności pracy oraz zespołu rozrzuconego pomiędzy kilkoma strefami czasowymi, udało się utrzymać pewną indywidualną elastyczność. Ogólnie wyszło to dosyć naturalnie. Tempo było sterowane przez naszą wewnętrzną wizję i plan oraz lokalnie dostosowywane w zależności od potrzeb klientów.
Odnośnie do tempa budowania produktu w każdej chwili pracy wydawało nam się, że pracujemy najszybciej, jak się tylko
da. Co w czasie t + Δ już okazywało się śmiesznie wolne, patrząc z perspektywy czasu. Teraz, będąc już w
pozycji z globalną perspektywą, łatwo to ocenić i podsumować. Pierwsze 2–3 miesiące można powiedzieć, że były „wolne”
pod kątem końcowego efektu na produkt. W tamtym czasie wydawało się to jak najbardziej zrozumiałe, ponieważ
tworzyliśmy fundamenty (infrastruktura, procesy, fundamentalne funkcjonalności, komunikacja serwisów itp.). Ponadto
staraliśmy się tworzyć te rzeczy solidnie. Było to bardzo naturalne dla nas. Oczywiście cały czas była świadomość, że
jesteśmy w startupie i iteracje powinny być szybkie. Myśleliśmy, że to rozumiemy wtedy, ale namacalnie to poczuliśmy
dużo później. Z dzisiejszej perspektywy mogę powiedzieć, że w tych pierwszych miesiącach było jeszcze widać u nas
nawyki wyrobione w pracy dla dużych organizacji. Każdego dnia te nawyki były coraz bardziej konfrontowane z realiami
startupowymi. Trzeba też dodać, że te pierwsze kilka miesięcy odbyły się przed publikacją Claude Code, Cursor oraz
bardziej zaawansowanych modeli językowych. Oczywiście używaliśmy dużo wsparcia AI, ale nie był to poziom końcówki 2025
roku. Dokładnie pamiętam, że co najmniej 100 000 linijek kodu (Go) w backendzie wytworzyłem w mniej niż 6
miesięcy, wtedy jeszcze nie używając wsparcia agentowego.
Nie podam tutaj dokładnych statystyk odnośnie do produktywności, tylko moje subiektywne oszacowanie. Wprowadzenie średnio dużej funkcjonalności w pierwszych kilku miesiącach zajmowało całemu zespołowi od 2 do 5 dni. Ówcześnie wydawało się to bardzo szybkie, w szczególności w porównaniu do tradycyjnych organizacji. Natomiast w szczycie produktywności i startupmaxxingu dochodziło nawet do 1–2 dużych funkcjonalności dziennie, włącznie z wdrożeniem na środowisko produkcyjne. Umożliwiało to implementację, testowanie, wdrożenie, prezentację dla klientów, dyskusję z klientami oraz zaplanowanie usprawnień kolejnej iteracji. Wszystko to często w ciągu 24 godzin (do dzisiaj podziwiam naszego CTO, który pracował na dwa etaty – w strefach czasowych EU z inżynierami oraz US z CEO i klientami, żeby tego dokonać). Następnego dnia kolejna iteracja. Nie mam dużo doświadczenia startupowego, ale ten poziom intensywności i podejścia do produktu nazwałbym właśnie startupowym podejściem.
Pivot
Po około 15–16 miesiącach mieliśmy gotowy (wedle jakiejś definicji) produkt. W tym czasie przeszedł on wiele iteracji na podstawie feedbacku naszych design partnerów oraz wstępnych klientów. W tym czasie okazało się, że sprzedanie ogólnej platformy do pracy z danymi jest dużo trudniejsze, niż przypuszczaliśmy. Dwa najważniejsze powody to zaufanie oraz decyzyjność. Zaufanie do zewnętrznych dostawców, którzy będą mieli dostęp do wewnętrznych danych, jest różne, ale zazwyczaj ograniczone (w szczególności w EU). Drugą i trudniejszą przeszkodą była decyzyjność. Zazwyczaj osoby, które testowały nasze rozwiązanie lub były nim zainteresowane (CDO, product manager, zespół analityczny itp.), nie miały wystarczającej pozycji, aby podjąć decyzję o zakupie oraz wdrożeniu. W efekcie bardzo negatywnie to wpływało na naszą sprzedaż. Kolejnym minusem, pod kątem sprzedaży, była ogólność naszego rozwiązania. Fakt, że nasze rozwiązanie działało dla wielu silników baz danych oraz wielu „typów” danych, był dla klientów nieintuicyjny. Dużo łatwiej sprzedać produkt, który rozwiązuje konkretny problem, a nie ogólny problem.
Efektem był pivot[1] w kierunku rozwiązania bardziej wertykalnego, rozwiązującego konkretny problem. W owym czasie nawet nie wiedzieliśmy, że jest to pivot. Z naszego punktu widzenia było to rozszerzenie naszej funkcjonalności o konkretny przypadek użycia. Z perspektywy czasu był to wyraźny pivot. Naszym nowym celem było zastosowanie wypracowanej inteligencji wokół danych do problemów związanych z reklamami i marketingiem ze skupieniem na Meta Ads (kiedyś Facebook Ads). Jak wspomniałem, nie traktowaliśmy tego jako pivotu, ponieważ skorzystaliśmy z ogólności naszej platformy i nowe funkcjonalności w kierunku marketingu i podejmowania decyzji były bardziej naturalnym rozszerzeniem niż przebudową lub zaczynaniem od nowa.
Ideologicznie nie byłem fanem pracowania w obszarze optymalizacji reklam i marketingu, lecz z perspektywy startupu była to dobra decyzja. Nasz CEO miał doświadczenie w tym obszarze oraz ekspozycję na klientów i ich problemy. Oczywiście wszyscy dążyliśmy do sukcesu, więc lekki ideologiczny zgrzyt nie był dużą przeszkodą. Z pozytywnej strony nowy problem odkrył dużo ciekawych wyzwań technicznych.
Meta Ads
Poza ciekawymi wyzwaniami było też dużo ciężkiej i żmudnej pracy. W szczególności chodzi mi o pracę z API Meta Ads. Blizny po tym doświadczeniu zostaną mi na długo... Sam ten podrozdział mógłby być postem samym w sobie, w tym miejscu natomiast nie będę wchodził w detale. Pierwszym krokiem było zrozumienie konceptów istniejących w (Facebook)Meta Ads takich jak account, campaign, ad set, ad, creatives, assets itd. oraz w jakich są relacjach. To było relatywnie dobrze udokumentowane, ale raczej tylko na wysokim poziomie. Dokładne zrozumienie encji oraz ich relacji okazało się dużo większym zadaniem analitycznym, niż przypuszczałem. Dodam, że na tym etapie był już dostępny Claude Code z modelem Fable. Główną przyczyną było wepchnięcie 20 lat historii, decyzji i rozszerzeń w istniejące dynamiczne pola. W efekcie struktura danego pola mogła się diametralnie różnić dla różnego rodzaju reklam (na przykład flexible ads) czy assetów. Co gorsza, pod kątem modelu danych, kontekst wpływał również na to, jak dane powinny być łączone albo który zestaw pól powinien być wybrany. Ani dla agentów LLM-owych, ani dla doświadczonych inżynierów danych dokumentacja nie była wystarczająca, nawet nie była blisko. Potrzebne było łączenie wiedzy z dokumentacji, informacji o tym, co klient widzi/ustawił w platformie Meta Ads, oraz o tym, jak zostało to odzwierciedlone w modelu danych. Dzięki temu wszystkiemu udało nam się zaprojektować i zbudować nasz wewnętrzny model danych dla Meta Ads. Taki, który dało się używać.
Początkowe trudności w modelowaniu danych Meta Ads to nie był koniec problemów w tym obszarze. W trakcie pracy okazało się, że Meta zmienia kontrakt API Meta Ads (na przykład usunięcie kilku pól) bez żadnego ostrzeżenia. Nawet nie ma informacji PO zdarzeniu. Dodatkowo dokumentacja często też nie jest aktualizowana w tym kontekście. W efekcie, sami musieliśmy monitorować jakość pól, które były krytyczne dla naszego wewnętrznego modelu.
Kolejną „ciekawostką” był fakt, że aby nasza platforma mogła korzystać z API Meta Ads, aplikacja w portalu Meta Ads musiała przejść proces weryfikacji. Okazało się, że proces jest manualny! Początkowo wymagał bardzo dużo danych od nas, w szczególności informacji o samej firmie, gdzie i jak jest zarejestrowana itp. Następnie część „weryfikacji” była robiona manualnie i trwała od kilku dni do trzech tygodni! Każda dodatkowa iteracja trwała co najmniej kilka dni. Z naszej perspektywy, kiedy klienci byli już umówieni na integrację, blokowanie wdrożenia przez proces weryfikacji było bardzo frustrujące. Może zbyt optymistycznie oczekiwaliśmy, że zajmie to maksymalnie kilka dni. Tak czy siak nie spodziewałem się takiej sytuacji w roku 2026 w jednej z większych firm technologicznych na świecie.
Finalnie, siłą rzeczy, dowiedziałem się o Meta Ads oraz ich modelu danych dużo więcej, niż kiedykolwiek bym pragnął. Co ciekawe, gdzieś w okolicy 2021–2022 roku brałem udział w rekrutacji do Meta na stanowisko Data Engineer (która zakończyła się przedwcześnie, bo stanowisko zostało już zajęte, zanim zakończyłem proces). Z tej perspektywy widzę, że jednak fajnie, że nic z tego nie było. Zdecydowanie uniknąłem kuli...
Refleksje
Produkt horyzontalny
Zanim jeszcze ConnectyAI przygotowało pitch deck[2], było bardzo poważnie rozważane, czy chcemy wybrać budowę produktu horyzontalnego (obejmującego wiele obszarów) czy wertykalnego (specjalistycznego). Zazwyczaj produkt wertykalny zyskuje większą przychylność inwestorów oraz jest łatwiej sprzedawalny. Z drugiej strony produkt horyzontalny ma większy potencjał rynkowy, ale za to trudniej go zbudować i sprzedać. Inwestorzy tylko potwierdzili ten pogląd. Najlepiej byłoby znaleźć produkt wertykalny, który może zostać rozszerzony horyzontalnie. To niestety jest dosyć trudne nawet w sferze teoretycznej.
W ConnectyAI zdecydowaliśmy się na produkt horyzontalny. Nawet patrząc z dzisiejszej perspektywy, uważam, że samo w sobie nie było to złą decyzją. Natomiast biorąc pod uwagę wysokość początkowej inwestycji, długość runwayu[3] oraz niedoszacowanie czasochłonności zbudowania wersji alpha platformy, to zapewne szanse faktycznie nie były duże. Oczywiście łatwo powiedzieć teraz. Dwa lata temu to w ogóle nie było takie jasne.
Product Market Fit
Głównym celem komercyjnych produktów jest zarabianie pieniędzy, zazwyczaj przez sprzedaż produktu lub usługi klientom. W cyklu życia produktu, po wizji oraz zbudowaniu pierwszej wersji produktu lub jego prototypu, nadchodzi faza, w której należy zderzyć to, co powstało, z rzeczywistymi potrzebami rynku. Często adaptacja produktu nie jest natychmiastowa. Użytkownicy mają uwagi lub potencjalni klienci mówią, że „kupiliby ten produkt, gdyby [...]”. Ta faza szlifowania produktu w kontekście rynku często jest nazywana Product Market Fit. W tym czasie produkt jest iteracyjnie dopasowywany do potrzeb rynku. To wszystko teoretycznie ma sens. Problem się pojawia, gdy grupy klientów mają sprzeczne wymagania co do funkcjonalności produktu. Albo gdy klient mówi, że kupiłby produkt, gdyby miał daną funkcjonalność, a po jej wdrożeniu jednak i tak się nie decyduje. Wydaje mi się, że w fazie PMF łatwo wpaść w pułapkę, że potencjalni klienci zbytnio wpływają na produkt, co może spowodować rozmycie wizji produktu i jego wewnętrznej integralności. To się akurat nie wydarzyło w ConnectyAI, ale byłem świadkiem, jak blisko było, żeby tak się wydarzyło. To oczywiście kolejna rzecz, którą łatwo powiedzieć, a dużo trudniej wykonać. Pod presją czasu oraz ograniczonych zasobów finansowych zdobycie klientów przez chwilowe poświęcenie integralności produktu może być niezbędne. W ConnectyAI nie byłem w pozycji, żeby decydować o tym, ale byłem dostatecznie blisko, żeby zrozumieć, jak trudne jest to zadanie.
Morale
Zazwyczaj w startupach dynamika pracy pod kątem najbliższych zadań jest bardzo duża. Problemy, nad którymi się pracuje, mogą się zmieniać dosłownie z dnia na dzień, w odróżnieniu od dużych organizacji, gdzie często przygotowuje się plany na kwartał lub nawet rok. Jest to coś, do czego trzeba się przyzwyczaić. Nie było to dla mnie zupełnie coś nowego – w consultingu również zmienność zadań lub projektów była zwykle duża.
W ConnectyAI często ta duża zmienność wpływała na morale zespołu. W fazach, w których był intensywny rozwój funkcjonalności i produkt rósł w oczach, morale było wysokie. Natomiast w czasach, gdy wstępny klient zrezygnował ze współpracy lub demo nie wyszło zbyt dobrze, oczywiście morale spadało. To jest naturalne. To, co według mnie z perspektywy czasu mogło być lepiej zrobione, to świadoma praca nad podniesieniem morale w tych trudniejszych momentach. Często tak się nie działo, bo wszyscy mieli jeszcze więcej pracy na głowie w tych sytuacjach. Każdy oczywiście jakoś sobie z tym radził. Osobistą lekcją na przyszłość dla mnie jest, żeby starać się reagować wcześniej w takich sytuacjach.
Osobiste Lekarstwo
Przez większość mojej kariery zawodowej zawsze miałem wizję, że jestem w stanie stworzyć (zaprojektować i zaimplementować) produkt, który mógłby być używany przez innych ludzi lub firmy i finalnie zbudować firmę wokół tego produktu. Nadal wierzę, że pierwsza część jest prawdziwa, natomiast mój czas w startupie pokazał mi, że druga część jest dużo trudniejsza. Sprzedaż, model biznesowy, marketing, networking, inwestycje – to tylko kilka z ważnych kwestii, o których wcześniej nie myślałem w szczegółach. Praca w startupie wyleczyła mnie z tej wizji, że mogę relatywnie łatwo skomercjalizować produkt. Oczywiście to nigdy nie był bezpośredni cel moich pobocznych projektów. Ale teraz wiem, z czym dokładnie się to wiąże.
Podsumowanie
Te dwa lata w ConnectyAI były dla mnie bardzo ciekawym czasem. Bardzo intensywny czas pod kątem pracy, nauki, nowych doświadczeń zawodowych. Czas, w którym zdobyłem bezcenne doświadczenie oraz poszerzyłem znacząco swoją perspektywę na kwestie biznesowe oraz produktowe. Chciałbym zakończyć ten post podziękowaniem dla całego zespołu ConnectyAI za wspólną pracę, wsparcie oraz inspirację. Ponadto szczególne podziękowania dla Aishy (CEO) oraz Piotrka (CTO) za zaufanie oraz możliwość pracy w ich startupie.
Referencje
- pivot – w kontekście startupu chodzi o znaczną zmianę biznesowej strategii.
- pitch deck – w kontekście startupu jest to prezentacja dla potencjalnych inwestorów, która przedstawia wizję, produkt, rynek oraz strategię biznesową startupu.
- runway – w kontekście startupu jest to czas, który startup może przetrwać finansowo przy obecnym tempie wydatków i przychodów. Często wyrażany w miesiącach.